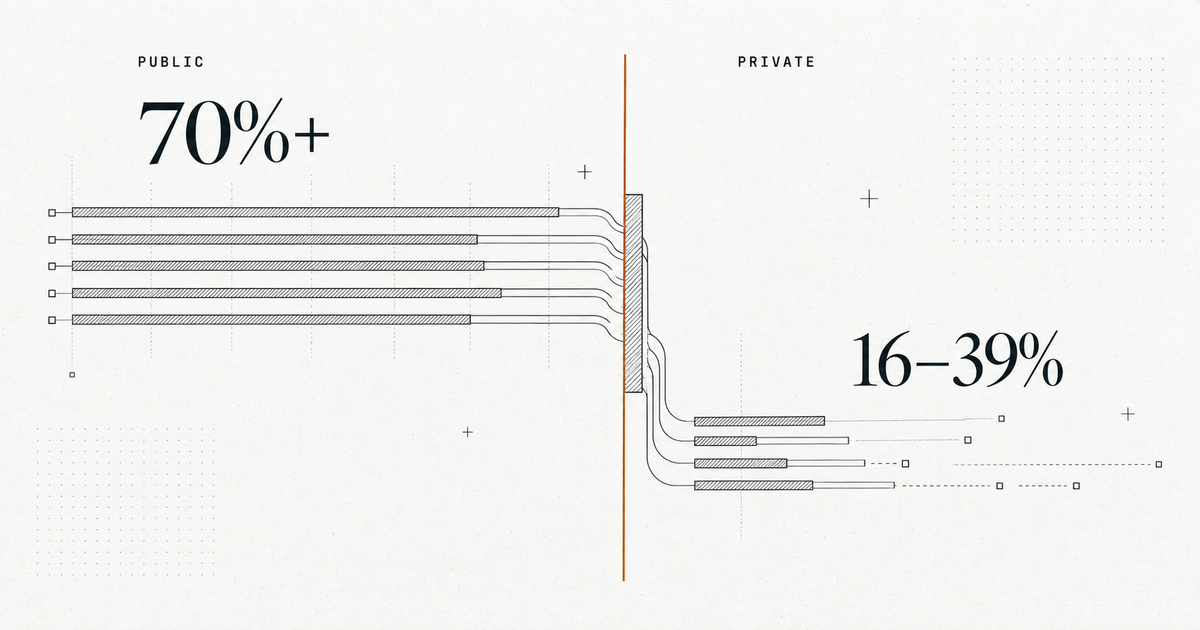
前沿模型在公開基準 SWE-bench Verified 上能拿 70%+,但一旦放進從未公開的真實企業生產程式碼庫,最高只解出 38.8% 的任務(Real-SWE),SWE-bench Pro 上約 23%。差距不在模型強弱,而在私有上下文。本文用具名基準和真實通過率對比表拆解這道落差,並給出企業讓 AI 在自己程式碼庫裡真正幹活的路徑。
企業級 AI 落地服務。派 FDE 駐場,把 AI 長進你的業務流程,大幅節省成本、贏得競爭。
© 2026 晨啟科技(6AM TECH)· AI-Native Precision · 保留所有權利